手元のデータを分析する際、「正規分布に従っていないかもしれない」「サンプル数が少なすぎて平均値の比較でよいのか不安だ」と頭を抱えるケースは珍しくありません。医療、ヘルスケア、マーケティング、社会調査など、実務で扱う生データには極端な外れ値や歪んだ分布がつきものです。そうした場面で真価を発揮するのがノンパラメトリック検定です。
前提条件に縛られず柔軟に使える一方で、「とりあえずこれを選んでおけば安全」という過信はデータの検出力を落とし、本来見つけるべき差を見落とすリスクもはらんでいます。本稿では、パラメトリック検定との根本的な違いから、実務で迷わない手法の選び方、主要ツールの操作フローまで、現場で即座に役立つ判断軸を徹底解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:ノンパラメトリック検定は母集団の分布型(正規分布など)を仮定せず、データの「順位(ランク)」を用いて差を検証する手法。
- 要点2:正規性の検定や外れ値の有無、サンプルサイズを手がかりに、t検定や分散分析と適切に使い分ける判断軸が不可欠。
- 要点3:EZRやSPSSを活用すれば数クリックで実行可能だが、検出力の低下や効果量の併記に留意して正しく解釈する必要がある。
【基礎知識】ノンパラメトリック検定とは?パラメトリック検定との決定的な違い
データ分析における検定手法は、大きく「パラメトリック検定」と「ノンパラメトリック検定」の2系統に分かれます。両者の最大の違いは、母集団の分布に特定の前提(正規分布など)を置くかどうかという点にあります。
パラメトリック検定は、データが正規分布に従うことを前提に、平均値や分散といった「パラメータ(母数)」を直接使ってグループ間の差を検定します。代表的な手法にはスチューデントのt検定や対応のあるt検定、分散分析(ANOVA)が挙げられます。データが前提条件を満たしていれば非常に検出力が高く、わずかな差も捉えやすいという大きなメリットを持ちます。
対するノンパラメトリック検定は、母集団の特定の分布型を前提としません。数値そのものの大きさではなく、データを小さい順に並べ替えた「順位(ランク)」の情報に変換して統計量を計算します。そのため、年収データのように極端な高額所得者が平均値を引き上げてしまう場合や、アンケートの満足度(5段階評価のリッカート尺度)といった順序尺度データに対しても、歪みに左右されず頑健な解析が可能です。
【判断基準】いつ使うべきか?迷った時の統計手法選び方フローチャート
「手元のデータにはどちらの手法を適用すべきか」という疑問に直面した際は、客観的なステップを踏んで判断していくのが鉄則です。判断に迷った場合は、以下の統計手法選び方フローチャートの流れに沿って精査を進めます。
第一の確認ポイントはデータの尺度です。名義尺度のクロス集計であればカイ二乗検定やフィッシャーの正確確率検定が選択肢になります。一方、間隔尺度・比率尺度の数値データ、あるいは順序尺度である場合は次のステップへ進みます。
第二のポイントは正規性の検定と外れ値の影響です。データが正規分布しているかを確認するため、ヒストグラムやQ-Qプロットでの視覚的確認に加え、シャピロ・ウィルク検定(Shapiro-Wilk test)を実施します。有意水準5%で帰無仮説が棄却された場合(p < 0.05)、データは正規分布に従っていないと判断され、ノンパラメトリック検定の出番となります。また、測定ミスや特異な事例による極端な外れ値が含まれている場合も、平均値が強く引っ張られるため、順位に基づくノンパラメトリック手法が安全です。
第三のポイントはサンプルサイズの目安です。1群あたりのサンプルサイズがn=10未満のような超小標本では、正規性の検定自体の信頼性が低くなるため、原則としてノンパラメトリック検定を採用するのが無難です。逆に各群n=30〜50を超えるような十分なサンプルサイズが確保されている場合、中心極限定理によって標本平均の分布は正規分布に近づくため、多少の歪みがあってもt検定の使い分けにおいてパラメトリック検定が許容されるケースが増えます。
【代表格を網羅】U検定からクラスカル・ウォリス検定まで主要手法一覧
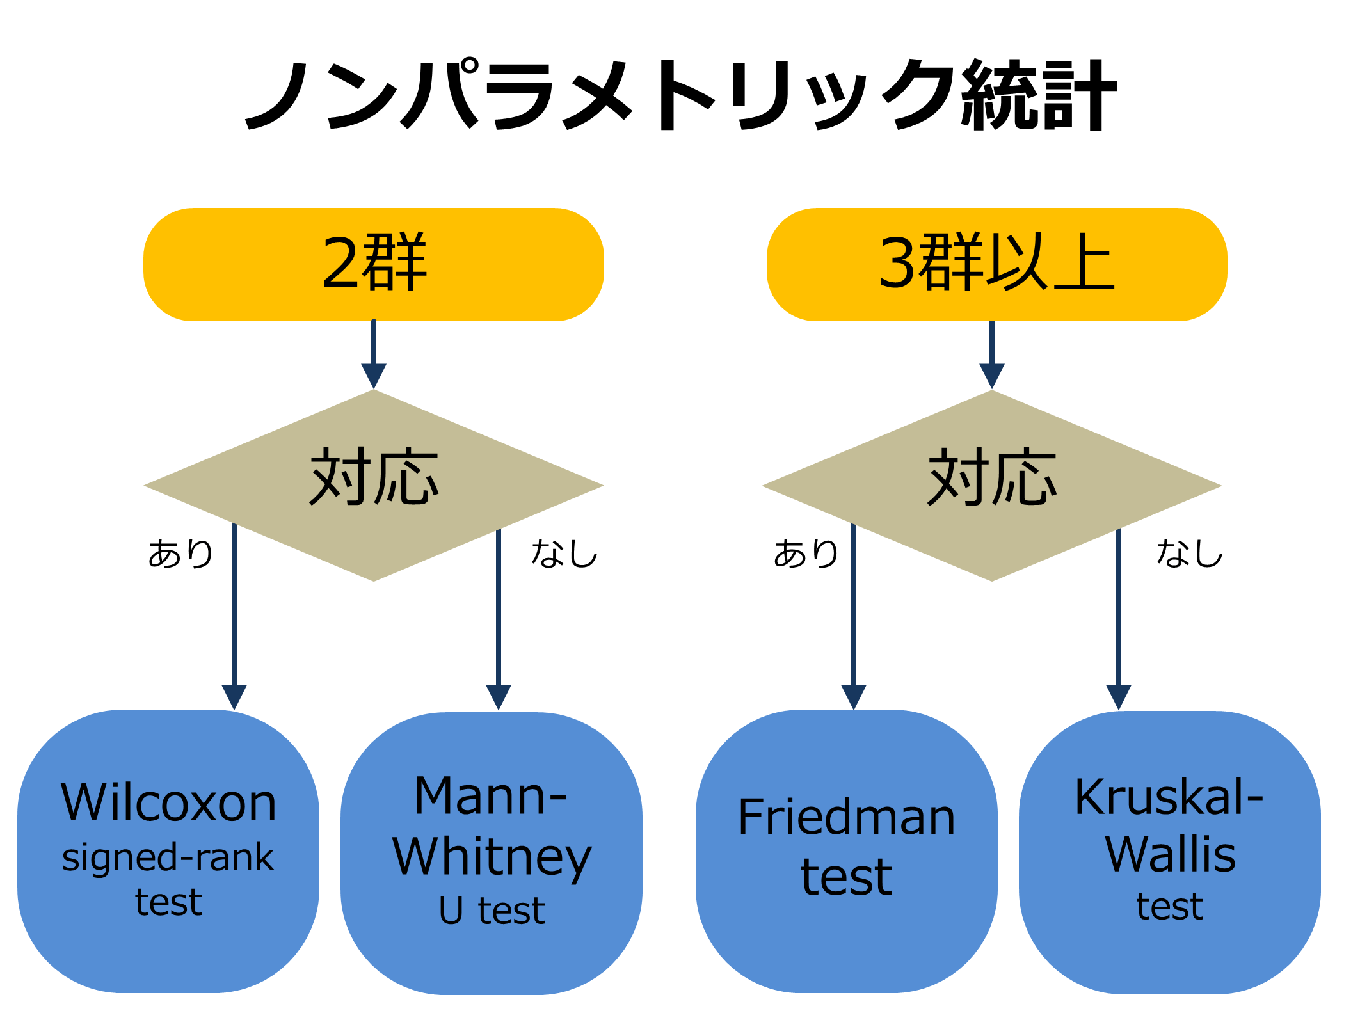
ノンパラメトリック検定には、パラメトリック検定の各手法に対応する「代替手法」が体系的に用意されています。目的とデータの対応関係に合わせて最適な手法を選択します。
① 2群の差を調べる(対応なし):マン・ホイットニーのU検定
独立した2つのグループ(例:新薬投与群とプラセボ群)の中央値や分布の位置に差があるかを調べます。パラメトリックにおける「対応のないt検定」の代替手法であり、ウィルコクソンの順位和検定と実質的に同一の検定です。全データを一括して順位付けし、グループごとの順位の合計を比較することで差を判定します。
② 2群の差を調べる(対応あり):ウィルコクソンの符号順位検定
同一の被験者に対する前後比較(例:研修前後のテストスコア、投薬前後の血圧)など、対応のあるデータペアを検証します。「対応のあるt検定」の代替手法です。ペアごとの差を算出し、その差の絶対値の大きさに対して順位を付け、符号(プラスかマイナスか)を考慮して検定統計量を導出します。
③ 3群以上の差を調べる(対応なし):クラスカル・ウォリス検定
3つ以上の独立したグループ(例:A部署・B部署・C部署の残業時間)を比較する手法で、「一元配置分散分析の代替手法」として機能します。クラスカル・ウォリス検定で有意差が認められた場合は、どのグループ間に差があるかを特定するためにスティール・ドゥワス法やボンフェローニ補正を用いた多重比較検定を追加で行う必要があります。
【実践ガイド】SPSSとEZRでの実行手順と結果の読み解き方
実際の解析現場で広く利用されている「SPSS」およびRベースの無料統計ソフト「EZR(Easy R)」での具体的な操作手順を整理します。
SPSSでの実行手順(マン・ホイットニーのU検定の場合):
メニューバーの「分析」→「ノンパラメトリック検定」→「レガシーダイアログ」→「2個の独立したサンプルの検定」を選択します。検定変数に測定値、グループ化変数に群分け変数を指定し、グループの定義を行います。「検定の種類」で「Mann-WhitneyのU」にチェックを入れて実行します。出力画面では、漸近有意確率(両側)またはサンプルサイズが小さい場合は正確有意確率のp値を確認します。
EZRでの統計解析(マン・ホイットニーのU検定の場合):
上部メニューの「統計解析」→「ノンパラメトリック検定」→「2群の比較(Mann-WhitneyのU検定)」をクリックします。目的変数とグループを表す変数を選択し、「OK」を押すだけで即座に結果が出力されます。EZRはRのコードを自動生成するため、再現性の確保にも優れています。
結果をレポートする際は、パラメトリック検定のように「平均値 ± 標準偏差」を記載するのではなく、「中央値(四分位範囲:IQR)」を併記するのが統計学的な作法です。あわせて検定統計量(U値やZ値)、p値、そして可能であれば効果量(r = Z / √N)を算出・記載することで、論文や事業レポートとしての客観的信頼性が格段に高まります。
【現場の落とし穴】ノンパラメトリック検定を適用する際の注意点
何でもノンパラメトリック検定で処理すれば万全かといえば、決してそうではありません。実務で陥りやすい落とし穴がいくつか存在します。
最大のデメリットは「第2種の過誤(偽陰性)」のリスク増加、すなわち検出力の低下です。データが本来正規分布に従っているにもかかわらず安易にノンパラメトリック検定を適用すると、実際の数値を「順位」という粗い情報に落とし込むことになるため、情報量が削ぎ落とされます。結果として「本当は差があるのに、有意差なしと判定される」事態が生じやすくなります。
また、順位をつける都合上、同じ測定値が複数存在する「タイ(同順位データ)」が多発する場合の補正にも配慮が求められます。タイが極端に多いと統計量の計算精度が下がるため、ソフトウェアがタイ補正を行っているか確認することが不可欠です。万能の魔法の杖ではなく、「前提が崩れたデータを救済するための精密な道具」と捉えるのが適切な姿勢です。
【ノンパラメトリック検定】に関するよくある質問(FAQ)
Q1:データが正規分布しているかどうかは、どのように最終判断すればよいですか?
A1:数値的な指標と視覚的な観察の両面から判断します。代表的な手法はシャピロ・ウィルク検定(サンプルサイズが大きい場合はコルモゴロフ・スミルノフ検定)で、p ≧ 0.05であれば正規性を棄却できません。ただし、標本サイズが非常に大きいとわずかな歪みでもp値が小さくなるため、Q-Qプロットやヒストグラムの形状、歪度・尖度をあわせて確認し、総合的に判断するのが一般的です。
Q2:サンプルサイズが極端に小さい場合、どちらの検定を使うべきですか?
A2:各群数件〜10件程度とサンプルサイズが極端に小さい場合は、正規性の判定自体が困難であり、外れ値1点の影響が甚大になるため、ノンパラメトリック検定を選択するのが安全です。その際、漸近検定ではなく「正確確率検定(Exact test)」オプションを指定してp値を算出することで、計算誤差を防ぐことができます。
Q3:ノンパラメトリック検定で「中央値の差」を検証していると言い切っても問題ありませんか?
A3:厳密には、マン・ホイットニーのU検定などが直接検証しているのは「2つの母集団の分布全体の形状と位置(順位の期待値)」です。「2群の分布の形状が同じ(分散などが同等)である」という前提が成り立つ場合に限り「中央値の差の検定」として解釈できます。分布の形が大きく異なる場合は、「一方の群の値が他方よりも全体的に大きい確率」を検定していると表現するのが学術的に正確です。
まとめ:2026年のデータ分析現場で信頼される解析を行うために
データドリブンな意思決定がビジネスでも学術でも当たり前となった今、統計処理の妥当性はかつてないほど厳しく問われています。正規分布を前提とするパラメトリック検定と、順位情報を用いて外れ値や歪みに耐性を持つノンパラメトリック検定。両者の特性を正しく理解し、データの尺度、分布の形状、サンプルサイズに応じた適切な選択を行うことが、誤った洞察を防ぐ防壁となります。
EZRやSPSSなどのツールが高度化したことで、検定そのものは数秒で完了します。だからこそ、「なぜその手法を選んだのか」というプロセスに説明責任を持つことが、信頼される分析者への確かな第一歩となります。 (出典: ノン パラメトリック 検定(Yahoo!ニュース))